Nowe akceleratory Google TPU 8tx i 8i Max. Podwójna przepustowość pamięci i sprzętowe szyfrowanie

Przejście od prostych czatbotów do autonomicznych agentów AI zmienia fizykę centrów danych. Gdy dziesiątki agentów jednocześnie analizują całe repozytoria kodu lub wielogodzinne nagrania wideo, wąskim gardłem przestaje być sama moc obliczeniowa, a staje się nim przepustowość pamięci oraz bezpieczeństwo przetwarzanych danych. Odpowiedzią Google na te wyzwania są dwa nowe systemy ósmej generacji: TPU 8i Max oraz TPU 8tx.
Nie nowy krzem, lecz nowy system wokół układu
Zaprojektowanie nowego układu scalonego od zera trwa latami, podczas gdy architektury modeli AI zmieniają się w cyklu miesięcznym. Jak tłumaczy Amin Vahdat, wiceprezes i główny technolog ds. infrastruktury AI w Google, firma obchodzi to ograniczenie, traktując swoje procesory jako modułowe klocki. Zamiast czekać na kolejną generację krzemu, inżynierowie w ciągu kilku miesięcy przeprojektowują jego otoczenie: sposób pakowania chipów, podsystemy pamięci, sieć optyczną i warstwę zabezpieczeń.
Dzięki takiemu podejściu Google po raz pierwszy w historii wprowadziło na rynek cztery systemy TPU w jednym roku. Do zaprezentowanych w kwietniu układów TPU 8t (stworzonego do trenowania wielkich modeli) oraz TPU 8i (zoptymalizowanego pod kątem wnioskowania w czasie rzeczywistym) dołączają teraz dwa wyspecjalizowane warianty zaprojektowane z myślą o wdrożeniach korporacyjnych i regulowanych.
TPU 8i Max rozbija „ścianę pamięci” podwójnym układem
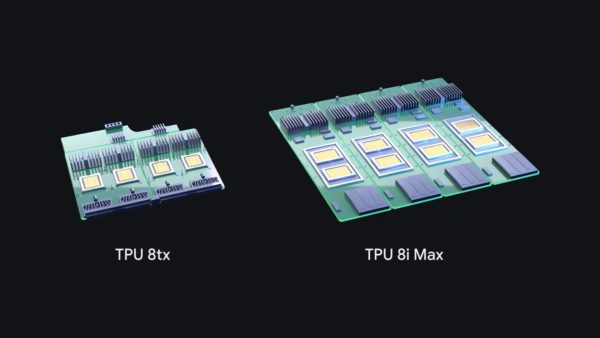
System TPU 8i Max powstał po to, by wyeliminować tzw. ścianę pamięci przy pracy na gigantycznych, milionowych oknach kontekstowych. Inżynierowie Google połączyli dwa niskoopóźnieniowe układy TPU 8i w jednej obudowie, skalując moc obliczeniową i podsystem pamięci dokładnie w tym samym tempie.
W efekcie TPU 8i Max oferuje dwukrotnie wyższą moc obliczeniową, dwukrotnie więcej pamięci SRAM oraz dwukrotnie większą przepustowość pamięci HBM niż standardowy model 8i. Co istotne z punktu widzenia operatorów centrów danych, podwójny układ mieści się w dokładnie tej samej przestrzeni szafy serwerowej, co pozwala zagęścić moc obliczeniową na metr kwadratowy i na wat zużytej energii.
TPU 8tx chroni dane nawet podczas obliczeń w pamięci
Druga nowość, TPU 8tx, celuje w instytucje rządowe, sektor finansowy i medyczny. Standardowo dane są szyfrowane na dysku i podczas przesyłania siecią, ale w momencie przetwarzania muszą zostać odszyfrowane w pamięci operacyjnej. TPU 8tx — bazujący na krzemie z modelu 8t i połączony z procesorami AMD EPYC 5. generacji — przenosi izolację bezpośrednio do warstwy sprzętowej, utrzymując wrażliwe dane oraz wagi modeli w formie zaszyfrowanej nawet podczas aktywnych obliczeń.
Zastosowanie autorskiej sieci Boardfly pozwoliło jednocześnie obniżyć opóźnienia nawet dwukrotnie względem modelu 8t przy niemal zerowym spadku wydajności. W praktyce oznacza to, że firmy mogą na jednym klastrze bezpiecznie uruchamiać agentów, dostrajać modele (fine-tuning) na własnych danych i prowadzić uczenie ze wzmacnianiem, bez konieczności przesyłania poufnych zbiorów między oddzielnymi serwerami.
Walka z bezczynnością agentów i otwarcie na PyTorch
Sama wydajność krzemu nie wystarczy, jeśli barierą wejścia pozostaje zamknięte oprogramowanie — to na tym polu Nvidia przez lata budowała swoją przewagę dzięki ekosystemowi CUDA. Google systematycznie rozbraja ten problem, udostępniając otwarte narzędzia takie jak TorchTPU (pozwalające uruchamiać kod PyTorch i modele z Hugging Face bezpośrednio na TPU bez przepisywania aplikacji) oraz natywne wsparcie dla silników vLLM i SGLang.
Wraz z nowymi układami zadebiutował też otwartoźródłowy system TPU Sync, który łączy pamięć HBM układu, pamięć RAM hosta, dyski i sieć w jedną hierarchię. Pozwala to przenosić gigantyczne bufory kontekstu (KV cache) poza układ w milisekundach, skracając czas do wygenerowania pierwszego tokenu (TTFT) o ponad 90%. Z kolei oprogramowanie Agent Compute Engine automatycznie usypia i wznawia sesje agentów AI w chwilach, gdy czekają one na odpowiedź z bazy danych lub decyzję człowieka, eliminując marnowanie mocy obliczeniowej na bezczynność.
Co ciekawe, przy projektowaniu kolejnych generacji własnych układów Google coraz mocniej polega na własnej sztucznej inteligencji — system AlphaChip oraz modele Gemini pozwalają przygotować rozkład elementów na krzemie w kilka godzin zamiast tygodni. Z infrastruktury TPU korzysta dziś blisko stu klientów zewnętrznych, w tym laboratoria AI, instytucje finansowe oraz firmy wdrażające te akceleratory bezpośrednio we własnych serwerowniach.
Gemini 4 Hydrogen trafia do wszystkich. Tańszy model Google pokonuje w testach droższego brata